Les démos sont belles. Les mesures, je les cherche encore.
Depuis un an, mon fil est rempli de SOC autonomes et de copilotes qui isolent une machine sans demander l'avis de personne. Et d'annonces qui expliquent que l'IA fera bientôt le métier mieux que nous, comme celui des médecins et des avocats. J'ai eu envie d'aller vérifier sur mon terrain, alors j'ai construit la mienne, je lui ai donné les commandes d'un défenseur de réseau, et je l'ai regardée travailler.
Ce qui m'intéressait n'était pas ce qu'elle sait. Sur la cybersécurité, elle en sait probablement plus que moi, et elle l'explique mieux. Ce que je voulais voir, c'est ce qu'elle fait quand elle a la main.
Dans un des scénarios, je lui envoie une alerte dont la source est difficile à identifier. Elle a isolé la machine attaquée. Autrement dit, elle a coupé elle-même le service que l'attaquant voulait faire tomber.
Trente fois sur trente, elle a fait, sans le savoir, le travail de l'attaquant à sa place.
Les règles du jeu
Avant d'en arriver là, les règles. On parle de cybersécurité, alors j'ai pris un modèle local : aucune observation du réseau ne part vers une API américaine. Donc pas de GPT-4, mais un llama3.2:3b exécuté avec Ollama, sur mon Mac.
Le reste ressemble à un jeu de plateau. À chaque tour, mon IA reçoit l'état du réseau raconté en texte, la liste des coups qu'elle peut jouer et son rôle, défenseur. Elle répond par un numéro d'action. Une partie dure 30 tours, et l'attaquant joue toujours avant elle.
Pour savoir ce que valent ses coups, il me fallait des concurrents : un joueur qui tire l'action au sort, un autre qui répète la même du début à la fin, une règle réactive à trois conditions, et un agent entraîné par apprentissage par renforcement (RL). Tout le monde joue les mêmes parties, dans le même ordre, avec les mêmes tirages, pour que les écarts viennent des décisions et pas de la chance.
Les deux terrains sortent de CybORG, la bibliothèque sur laquelle s'appuie la recherche du domaine. CAGE 2 d'abord, un réseau d'entreprise de 13 machines avec 145 actions possibles et un attaquant qui suit toujours le même chemin. DroneSwarm ensuite, un essaim de 18 drones avec 56 actions et un adversaire qui change d'une partie à l'autre.
Ces deux terrains ont un défaut, et c'est justement ce défaut qui m'intéresse : aucun ne ressemble à une infrastructure moderne. C'est pour ça que j'en ai monté un troisième moi-même.
Le code, les résultats bruts et le modèle entraîné sont sur github.com/will0fried/uscb06-agents-cyberdefense. Tout est rejouable.
Mille parties plus tard, le hasard fait mieux que mon IA
Premier terrain, le réseau d'entreprise, avec l'attaquant qui fonce toujours vers le même serveur. Le plus facile des deux, donc. 1 000 parties pour chacun des cinq joueurs. Plus le score est proche de zéro, mieux le réseau a été défendu.
Relisez la dernière ligne. Tirer une action au hasard défend mieux ce réseau que mon IA, et l'écart n'est pas une question de chance : les intervalles de confiance des deux ne se touchent même pas.
L'agent par renforcement, lui, écrase le classement. Retenez-le, il ne tiendra pas jusqu'au bout de l'article.
Sur le terrain des drones, elle agit dans le vide
Deuxième terrain, l'essaim de drones, avec un adversaire qui change d'une partie à l'autre. Mêmes règles, mêmes 1 000 parties.
Cette fois, personne ne défend. Sur le réseau d'entreprise, 150 points séparaient le vainqueur du hasard. Ici, l'agent par renforcement ne prend que 11 points au tirage au sort. Et mon IA ferme encore la marche.
L'intéressant n'est pas dans le classement, il est dans la façon dont elle joue. Voici un échange réel au premier tour, extrait d'une série exploratoire de 25 tours menée avant que je n'uniformise à 30. Aucun drone compromis, aucune alerte, rien.
SITUATION (tour 1 sur 25) :
- drone_0 : rien a signaler
- drone_1 : rien a signaler

--- REPONSE DU LLM ---
Puisque nous sommes au tour 1 sur 25, il est important de prendre
une action pour eviter que le ver ne se propage trop rapidement.
Je vais bloquer le trafic venant du drone 1.

ACTION=19+1
Le raisonnement se lit bien, il est même convaincant si on ne regarde pas la situation. Sauf qu'il n'y a rien à défendre et qu'elle coupe quand même un drone.
C'est le motif que j'ai retrouvé partout : elle produit du texte plausible, et le texte plausible n'a pas de rapport particulier avec la bonne décision.
Elle isole la victime, pas l'attaquant
Alors j'ai monté ma propre maquette, un cœur de réseau 5G sur Kubernetes, avec cinq scénarios d'incident dont j'avais écrit la bonne réponse avant de lancer quoi que ce soit.
Le scénario piège est celui de l'introduction. Une fonction du cœur signale qu'elle est attaquée, mais la source est noyée dans le bruit. Mon IA isole celle qui a donné l'alerte. La victime. Trente fois sur trente.
Couper cette fonction-là, c'est couper l'accès au réseau pour les abonnés. L'objectif de l'attaquant, atteint par la défense.
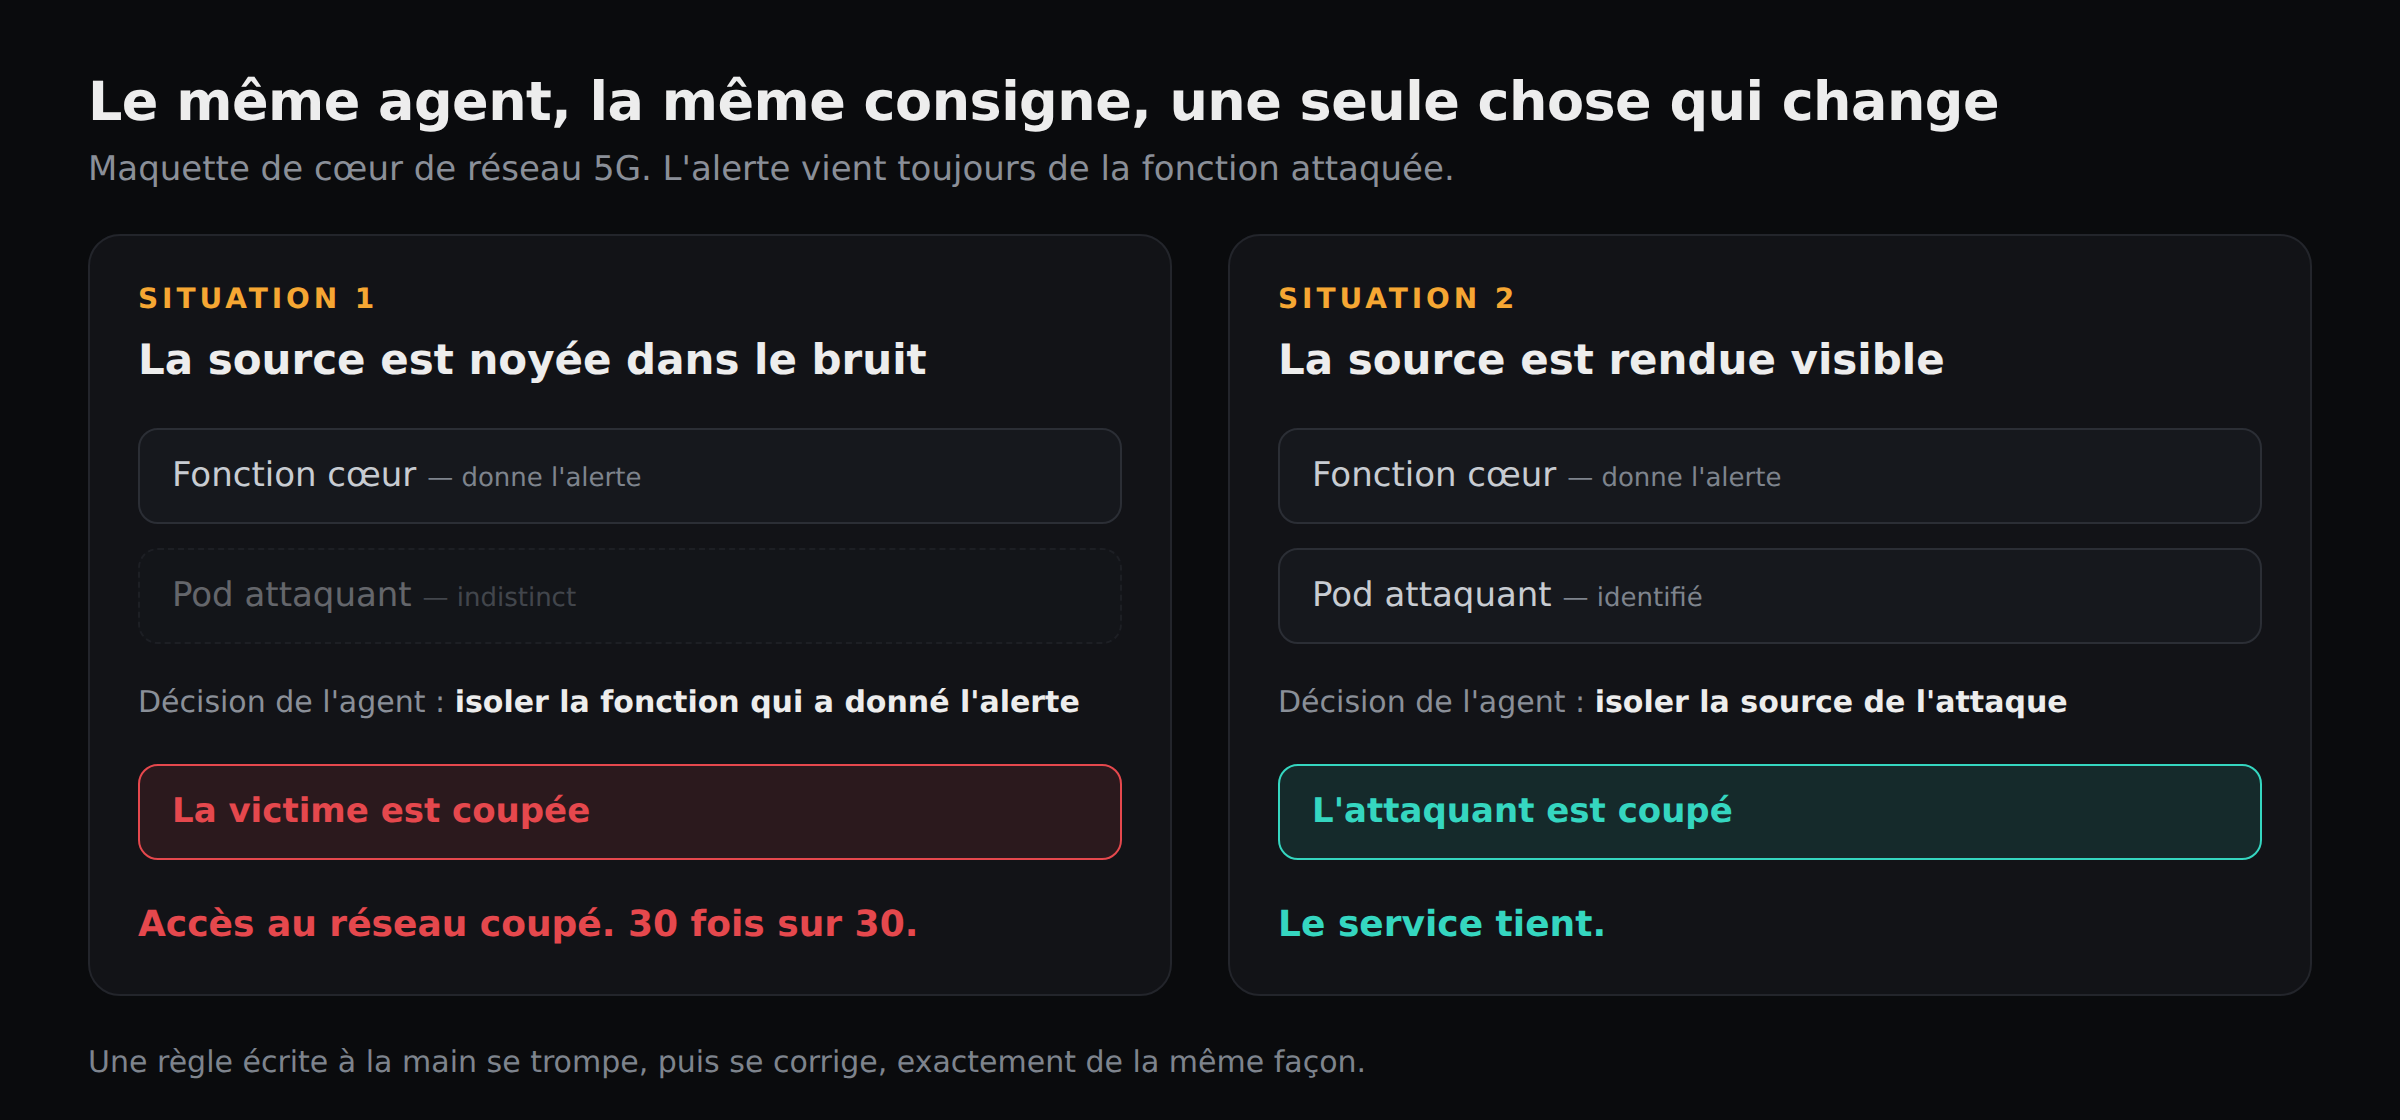
Je change ensuite un seul paramètre, je rends la source visible dans ce qu'elle observe. Et elle isole l'attaquant.
La règle à trois conditions se trompe pareil, et se corrige pareil.
Ce n'est pas l'intelligence du décideur qui tranche, c'est ce qu'on lui met sous les yeux.
Sur cette maquette, j'ai aussi lancé un modèle local plus gros, un llama3.1:8b. Il réserve une dernière surprise. Il vise juste plus souvent que mon IA, mais dans trois scénarios sur cinq, il n'exécute rien, il décrit la bonne action sans jamais la déclencher. Pour le réseau, une décision juste qui n'est pas exécutée, c'est une absence de défense.
Ne me croyez pas trop vite
J'avais 1 000 parties, des intervalles de confiance et un classement net. Il ne valait que contre un seul attaquant, et je ne l'avais pas vu.
J'ai donc tout rejoué en ne changeant qu'une seule chose, l'attaquant. Le nouveau explore le réseau de proche en proche au lieu de foncer sur le serveur critique. Et tout bouge.
Mon IA n'est plus qu'à un point et demi sous le hasard. L'agent par renforcement recule, je vous avais prévenu. Quant à l'action fixe, taillée pour le chemin du premier attaquant, elle passe sous le tirage au sort.
« Elle fait pire que le hasard » n'est donc pas une propriété de mon IA, c'est une propriété du couple qu'elle forme avec son adversaire. Un attaquant réel ne prévient pas quand il change de méthode.
Et là, je vous entends déjà : forcément, tu as pris un petit modèle sur ton Mac, avec GPT-4 ce serait autre chose. C'est vrai, une équipe l'a fait. Avec GPT-4, elle atteint le niveau du meilleur agent du challenge (Mohammadi, Davis et Kiely, 2025). Mais sa réussite tient à trois conditions : un gros modèle distant, une consigne longuement travaillée, et un seul attaquant. Changez l'attaquant, leur agent décroche lui aussi. Ces trois conditions, en production, on ne les a pas.
Alors, est-ce qu'elle va nous remplacer ?
Il y a un étage dont on ne parle jamais dans les démos, celui de l'exécution. Savoir quoi faire est une chose, déclencher vraiment l'action en est une autre, et c'est là que le gros modèle échoue. La question à poser, devant une démo, c'est ce qui se passe le jour où l'ordre ne part pas.
Le reste dépend de ce qu'on lui donne à voir. Trois décideurs très différents se sont trompés de la même façon quand la source était cachée, et ont visé juste quand elle était visible. Le gros du travail n'était pas dans la consigne, il était dans l'observation.
Deux défauts s'ajoutent, sans rapport avec la qualité de ses décisions. Elle met huit secondes à choisir un coup, et un ver qui se propage de machine en machine ne l'attend pas. Elle ne rejoue pas non plus deux fois la même partie de la même façon, même avec la température réglée à zéro. Le phénomène est documenté (Atil et al., 2024). Rien ne garantit qu'elle refera demain ce qu'elle a fait aujourd'hui.
Ma réponse, avec ce que j'ai mesuré. Elle a sa place en appui de l'analyste, pour expliquer, résumer, proposer. Pas aux commandes d'une infrastructure critique, et pas sans une règle simple en garde-fou devant elle.
Pour être clair sur les limites, je n'ai testé que deux petits modèles locaux, avec une consigne simple et des données simulées. Je ne dis rien des grands modèles ni d'une consigne d'expert. Mon banc d'essai, lui, est calibré sur le classement officiel du challenge. Mon joueur aléatoire tombe à 0,4 % du leur, et mon agent par renforcement se cale entre l'agent vainqueur et l'implémentation de référence. Les campagnes où je lui restreignais le menu d'actions sont dans le dépôt comme le reste. Elle y descend à -188,42.
Alors si quelqu'un vous vend un défenseur autonome, la question tient en une phrase. Mesuré dans quelles conditions, avec quel modèle, contre quel attaquant ?